Ein einzelner Trainingslauf erklärt noch nicht, wo die nächste Ausbaustufe des KI-Budgets gebraucht wird.
Schnellste Einordnung: Für NVIDIA GTC Berlin 2026 ist als Arbeitshypothese sinnvoll, nicht nur größere Trainingskapazität einzuplanen, sondern auch effiziente Inferenz, dauerhaft laufende AI Agents und die Zusammenarbeit von Cloud, Edge und lokalen Systemen. Das ist eine belastbare Trendanalyse aus den Arbeitslasten, aber keine bestätigte Aussage zum Programm oder zu Ankündigungen der Veranstaltung.
Dieser Beitrag ist für technische Verantwortliche gedacht, die KI-Infrastruktur oder Rechenbudgets planen und Einsatzorte vergleichen müssen.
Entwickler von AI Agents, Open Models und Robotiksystemen erhalten Kriterien für Inferenz und Bereitstellung.
Branchenbeobachter können die Analyse nutzen, um bestätigte Angaben von Prognosen zu trennen.
Zuletzt aktualisiert: 2026; Quellenprüfung anhand der offiziellen GTC-Seiten und der verlinkten technischen Dokumentation. Die verfügbaren Quellen dienen dazu, bestätigte Veranstaltungsinformationen später nachzuprüfen; aus ihnen werden hier weder ein konkreter Termin oder Veranstaltungsort noch nicht belegte Produktankündigungen abgeleitet.
NVIDIA GTC Berlin 2026 als Prüfpunkt für die Rechenrichtung
Die entscheidende Planungsfrage lautet nicht allein, welche GPU oder welches Modell vorgestellt wird. Relevant ist, ob sich die Art der Arbeit verändert: Wird ein Modell einmal trainiert und danach selten aufgerufen, oder beantwortet es dauerhaft Anfragen, nutzt Werkzeuge und steuert Prozesse? Findet die Berechnung in einem Rechenzentrum statt, muss sie nahe an einer Maschine laufen, oder braucht ein Entwickler lediglich eine Apple-Entwicklungsumgebung?
Das sind unterschiedliche Lastprofile. Sie verlangen andere Kombinationen aus Rechenleistung, Arbeitsspeicher, Speicherzugriff, Netzwerkanbindung und Reaktionszeit. Deshalb ist die Prognose „mehr KI bedeutet mehr GPUs“ zu grob, um eine Investition zu begründen. Eine steigende Zahl von Inferenzanfragen kann zusätzliche GPU-Kapazität nötig machen; sie kann aber ebenso Druck auf Modellgröße, Auslastung, Zwischenspeicherung und Dienstarchitektur ausüben.
Als Faktenbasis sollten offizielle Programm- und Veröffentlichungsseiten herangezogen werden. Der offizielle GTC-Sitzungskatalog ist der geeignete Ort, um angekündigte Sitzungen zu prüfen. Die offiziellen GTC-FAQ dienen zur Kontrolle von Veranstaltungsangaben. Solange eine konkrete Information dort nicht bestätigt ist, bleibt sie offen. Eine Prognose aus den folgenden Abschnitten ist entsprechend keine Vorhersage eines bestimmten Vortrags oder Produkts.
Für die Infrastrukturplanung ist eine andere Trennung mindestens ebenso wichtig: GPU-Rechnen und eine Mac-Entwicklungsumgebung lösen nicht dieselbe Aufgabe. GPU-Systeme sind für passende KI- und Grafiklasten ausgelegt. Ein Cloud-Mac kann dagegen für Apple-Ökosystem-Entwicklung, Builds oder Tests relevant sein, ersetzt aber weder ein GPU-Rechenzentrum noch eine Robotik-Edge-Plattform.
GPU-Arbeit zwischen Training und Inferenz
Wie könnte NVIDIA GTC Berlin 2026 den GPU-Bedarf beeinflussen? Der relevante Such- und Planungsaspekt ist weniger eine pauschale Nachfrage nach „mehr GPU“ als die Verteilung zwischen Training und Inferenz. Training verarbeitet Daten, um Modellparameter anzupassen; produktive Inferenz führt ein trainiertes Modell aus und muss oft fortlaufend Anfragen mit definierten Antwortzeiten bedienen. Daraus entstehen unterschiedliche Engpässe.
Beim Training stehen Rechenzeit, Speicherbedarf, Datenzufuhr und die effiziente Auslastung einer Beschleunigergruppe im Mittelpunkt. Bei Inferenz zählen zusätzlich die Zahl gleichzeitiger Anfragen, die Antwortlatenz, der Durchsatz und die Kosten je bearbeiteter Aufgabe. Der NVIDIA-Leitfaden zur Inferenz-Referenzarchitektur behandelt Inferenz als eigene Architekturaufgabe. Das stützt die Unterscheidung zwischen Modelltraining und dem Betrieb eines Inferenzdienstes, ohne daraus eine bestimmte Leistungskennzahl oder ein Produktversprechen abzuleiten.
Ein wachsender Inferenzanteil bedeutet nicht, dass Training verschwindet. Neue Modelle, domänenspezifische Anpassungen und regelmäßige Aktualisierungen benötigen weiterhin Trainings- oder Feinabstimmungsressourcen. Zudem kann ein Agent mehrere Modellaufrufe für eine Aufgabe auslösen. Eine einzelne Nutzeranfrage ist dann nicht gleichbedeutend mit einem einzelnen Inferenzdurchlauf. Die tatsächliche GPU-Auslastung hängt von Modellwahl, Anfrageform, Parallelität und der Architektur des Dienstes ab.
Für Entscheidungen sollte ein Team deshalb Lastdaten erheben, statt den erwarteten GPU-Bedarf aus der Zahl der Nutzer abzuleiten. Sinnvolle Messgrößen sind die Antwortlatenz, der Durchsatz, der GPU-Speicherbedarf, die Auslastung und die Häufigkeit von Spitzenlasten. Ein Test mit repräsentativen Anfragen ist aussagekräftiger als ein isolierter Lauf mit einem großen Modell, weil die Produktionsumgebung auch Wartezeiten, Datenzugriffe und parallele Aufträge umfasst.
AI Agents als fortlaufende Arbeitslast
Welche Verschiebung ist bei AI Agents plausibel? Ein Agent kann ein Modell aufrufen, den Kontext aufbereiten, ein Werkzeug ansteuern, dessen Ergebnis bewerten und anschließend weitere Schritte planen. Der NVIDIA-Beitrag zu agentischer Inferenz stellt diese Art der Inferenz als eigenen Arbeitslastbereich dar. Für die Infrastruktur folgt daraus eine wichtige Einschränkung: Nicht jeder Schritt benötigt dieselbe Hardware und nicht jeder Schritt ist überhaupt eine GPU-Berechnung.
Der Modellaufruf kann GPU-Kapazität beanspruchen. Kontextverwaltung, Aufgabenstatus, Protokollierung, Berechtigungsprüfung und Werkzeugverbindungen sind dagegen häufig Dienste, die auf CPU-, Speicher- und Netzwerkressourcen angewiesen sind. Datenbankabfragen oder der Aufruf einer internen API verursachen wiederum Latenz außerhalb des Modells. Wer den gesamten Agenten als „GPU-Last“ verbucht, riskiert daher, den falschen Teil der Architektur zu skalieren.
Für einen Agenten, der sensible Daten verarbeitet oder mit internen Systemen arbeitet, kommen Betriebs- und Sicherheitsanforderungen hinzu: Zugriff auf Werkzeuge muss begrenzt, der Datenfluss nachvollziehbar und der Umgang mit Protokollen geklärt sein. Nach DSGVO-Grundsätzen sollte ein Team prüfen, welche personenbezogenen Daten in Prompts, Zwischenergebnissen und Logs landen, wer Zugriff erhält und wie lange solche Daten gespeichert werden. Die Entscheidung für Cloud, Edge oder lokale Ausführung ist daher nicht nur eine Frage der Rechenleistung.
Cloud-Ausführung passt eher, wenn ein Agent skalierbare Modellinferenz oder zentrale, gemeinsam genutzte Werkzeuge benötigt und die Netzwerklatenz vertretbar ist. Edge-Betrieb ist interessant, wenn Reaktionen nahe an einem Gerät oder einer Produktionsanlage erfolgen müssen oder eine Verbindung nicht zuverlässig vorausgesetzt werden kann. Lokal laufende Komponenten können sinnvoll sein, wenn Daten das Gerät nicht verlassen sollen oder ein klar begrenzter Einzelarbeitsplatz genügt. Die genaue Grenze muss aus Sicherheitsmodell, Antwortzeit und Ausfallszenario folgen; eine allgemeine Regel, nach der Agenten immer in die Cloud gehören, gibt es nicht.
Open Models und die Wahl des Bereitstellungsmodells
Was verändert ein Open Model an der Inferenzbereitstellung? Wenn Gewichte zugänglich sind und die Lizenz die geplante Nutzung erlaubt, kann ein Team ein Modell in einer eigenen Umgebung testen, feinabstimmen oder als privaten Dienst bereitstellen. Das kann neue Einsatzszenarien eröffnen, bedeutet aber nicht automatisch niedrigere Betriebskosten: Hardware, Wartung, Modellpflege, Auslastung und Sicherheitsprüfungen bleiben Teil der Rechnung.
Dabei sind Begriffe sauber auseinanderzuhalten. „Offene Gewichte“ bedeutet nicht zwangsläufig, dass Trainingsdaten, Trainingsverfahren und Quellcode offenliegen. Eine offene Lizenz wiederum kann Nutzungsbedingungen enthalten, die für einen konkreten kommerziellen oder verteilten Einsatz relevant sind. Die Definition für Open-Source-KI der Open Source Initiative beschreibt vier grundlegende Freiheiten: ein KI-System zu nutzen, zu untersuchen, zu verändern und weiterzugeben. Ob ein bestimmtes Modell diese Anforderungen erfüllt, muss anhand seiner konkreten Dokumentation und Lizenz geprüft werden; die Bezeichnung „offen“ allein reicht als Nachweis nicht.
Die praktische Konsequenz ist eine mögliche Ausweitung der Bereitstellungsoptionen, nicht die automatische Verlagerung jeder Inferenz auf eigene GPUs. Ein Team kann ein offenes Modell lokal für einen Prototyp testen, es auf eigener Infrastruktur als privaten Dienst betreiben oder verwaltete Kapazität nutzen. Jede Variante hat andere Kostenstellen: Anschaffung oder Mietkosten, GPU-Auslastung, Speicher, Netzwerk, Aktualisierung und der Aufwand für Monitoring und Bereitschaft.
Feinabstimmung und Inferenz sind zudem verschiedene Lasten. Eine Anpassung kann zeitlich begrenzte Trainingsressourcen benötigen; der spätere Betrieb verursacht wiederkehrende Inferenzlast. Vor der Beschaffung sollte daher feststehen, ob tatsächlich eine Modellanpassung nötig ist oder ob Prompting, Retrieval und ein bestehender Dienst ausreichen. Die Modellkarte, Lizenz, dokumentierten Fähigkeiten und etwaige Nutzungseinschränkungen gehören in diese Prüfung, nicht erst in die Bereitstellung.
Robotik zwischen Simulation, Edge und Cloud
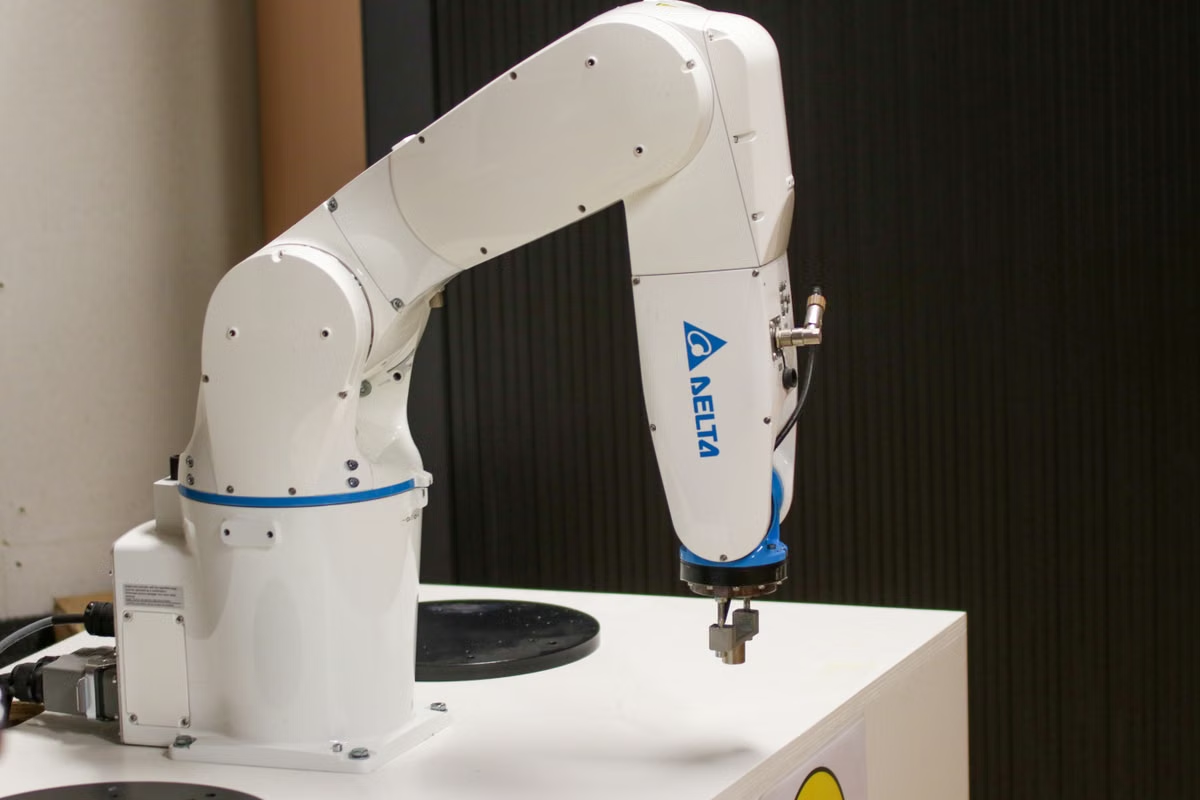
Bei Robotern laufen mehrere Rechenaufgaben in unterschiedlichen Umgebungen zusammen. Simulation und Training können umfangreiche Datenverarbeitung und wiederholbare Tests erfordern. Die Wahrnehmung eines Roboters vor Ort und die Steuerung einer Bewegung können dagegen enge Anforderungen an Reaktionszeit und Verfügbarkeit stellen. Modellaktualisierungen und Flottenauswertungen lassen sich wiederum zentral organisieren, sofern die Datenübertragung und der Betriebsablauf dazu passen.
Die NVIDIA-Entwicklerressourcen zu Robotik und Edge AI verknüpfen Robotik mit Anwendungen am Netzwerkrand. Das ist für die Einordnung relevant: Die Berechnung muss nicht ausschließlich in einem Rechenzentrum erfolgen. Wird eine Aktion durch Netzwerklatenz oder eine unterbrochene Verbindung unsicher, ist eine lokale oder Edge-Komponente für die zeitkritische Reaktion nötig. Cloud-Rechenleistung kann solche Aufgaben nicht pauschal ersetzen.
Für die Budgetplanung sollten mindestens drei Lastgruppen getrennt erfasst werden. Erstens die Entwicklung und Simulation, die oft planbare, größere Rechenläufe erlaubt. Zweitens die Wahrnehmung und Steuerung am Einsatzort, bei denen Latenz, Verfügbarkeit und die vorhandene Edge-Hardware zählen. Drittens die Auswertung von Betriebsdaten und die Bereitstellung neuer Modelle, die zentral erfolgen können, wenn Datenschutz, Bandbreite und Aktualisierungsfenster dies zulassen.
Diese Aufteilung macht auch deutlich, warum ein GPU-Cluster und ein Cloud-Mac nicht austauschbar sind. GPU-Ressourcen können für Simulation, Training oder Inferenz erforderlich sein. Ein Mac in der Cloud ist eine Entwicklungsumgebung für Aufgaben im Apple-Ökosystem, etwa wenn eine zugehörige Anwendung gebaut oder getestet werden muss. Er ist kein Ersatz für die GPU-Rechenleistung einer Robotik- oder KI-Pipeline.
Prüfschritte für die Einordnung neuer Informationen
Vor einer Investition oder einer Änderung der Architektur sollten Verantwortliche die Angaben aus einer Veranstaltung in eine überprüfbare Arbeitsliste übertragen. Die folgende Reihenfolge hält Prognosen, Anforderungen und Beschaffungsentscheidungen auseinander:
- Arbeitslast beschreiben: Festhalten, ob es um Training, Feinabstimmung, Inferenz, Agenten-Orchestrierung, Simulation oder Steuerung am Gerät geht. Ein Produktname ersetzt diese Beschreibung nicht.
- Betriebsprofil messen: Repräsentative Anfragen oder Abläufe erfassen und Antwortlatenz, Durchsatz, Speicherbedarf, Parallelität sowie Spitzenlasten dokumentieren. Messungen müssen zur erwarteten Produktionslast passen.
- Einsatzort festlegen: Für jeden Verarbeitungsschritt prüfen, ob er in der Cloud, am Edge oder lokal ausgeführt werden kann. Datenschutz, Netzverbindung, Ausfallfolgen und Reaktionszeit gehören in dieselbe Entscheidung.
- Modellstatus verifizieren: Bei einem Open Model Gewichte, Lizenz, Modellkarte und dokumentierte Fähigkeiten getrennt prüfen. Bei angekündigten Änderungen nur offizielle Veröffentlichungen als bestätigt behandeln.
- Gesamtkosten vergleichen: Neben GPU-Zeit auch Speicherung, Netzwerk, Betrieb, Überwachung, Aktualisierung und Bereitschaft einrechnen. Für eine Mac-Entwicklungsumgebung ist eine gesonderte Betrachtung sinnvoll, weil sie andere Aufgaben abdeckt als GPU-Training.
- Aussagen klassifizieren: Offizielle Programmangaben und technische Dokumentation als bestätigt markieren, Medienberichte als Berichte kennzeichnen und eigene Schlussfolgerungen ausdrücklich als Prognose notieren.
Die Tabelle dient als Arbeitsinstrument: Sie ordnet nicht nach Herstellern, sondern nach dem Engpass, der im jeweiligen Szenario zuerst geprüft werden sollte.
| Szenario | Primärer Rechenbedarf | Entscheidende Prüfgröße | Naheliegender Einsatzort |
|---|---|---|---|
| Modelltraining | GPU-Rechenleistung und Speicher | Laufzeit, Speicherauslastung, Datenzufuhr | Cloud oder eigenes Rechenzentrum |
| Produktionsinferenz | Wiederholte Modellaufrufe | Latenz, Durchsatz, Parallelität | Cloud, lokal oder Edge, je nach Dienstziel |
| AI Agent | Modellaufrufe plus Orchestrierung | Zahl und Ablauf der Werkzeuge, Fehlerbehandlung, Protokolle | Verteilt auf Modellservice und Anwendungsdienste |
| Robotiksteuerung | Wahrnehmung und zeitnahe Reaktion | Latenz, Verfügbarkeit, Verhalten bei Verbindungsabbruch | Gerät oder Edge |
| Apple-Ökosystem-Entwicklung | Build, Test und Integration | benötigte Entwicklungsumgebung und Testziel | Lokaler Mac oder Cloud-Mac |
Entscheidung nach Arbeitslast statt nach Schlagwort
Welche Angaben sollten nach der Veranstaltung zuerst abgeglichen werden? Zuerst sind offizielle Aussagen zu Programm, Technik und Verfügbarkeit von Kommentaren oder Medienberichten zu trennen. Danach ist zu prüfen, ob eine Ankündigung eine neue Rechenaufgabe löst oder nur eine bestehende Aufgabe anders verpackt. Der Sitzungskatalog und die GTC-FAQ sind hierfür offizielle Bezugspunkte; eine noch nicht veröffentlichte Angabe bleibt unbestätigt.
Die gemeinsame Linie über GPU, AI Agents, Open Models und Robotik ist nicht zwangsläufig ein einzelner größerer Beschleuniger. Plausibler ist eine differenziertere Verteilung: Training bleibt relevant, Inferenz muss effizient und zuverlässig laufen, Agenten verbinden Modell- mit Dienstlasten, und Robotik teilt Berechnung zwischen zentraler Infrastruktur und dem Einsatzort auf. Diese Einschätzung sollte nach offiziellen Sitzungs- und Produktinformationen angepasst werden, statt als bereits feststehendes Ergebnis von NVIDIA GTC Berlin 2026 behandelt zu werden.
| Entscheidungsfall | Geeignete Option | Grenze, die vorab geprüft werden muss |
|---|---|---|
| Wiederkehrende, GPU-intensive Modelllast | GPU-Infrastruktur passend zum gemessenen Modell- und Anfrageprofil | Auslastung, Speicherbedarf, Wartung und Netzwerkkosten |
| Zeitkritische Geräte- oder Roboterreaktion | Lokale oder Edge-Berechnung für den unmittelbaren Regelkreis | Hardwaregrenzen, Aktualisierung und Verhalten ohne Verbindung |
| Zentrale, wechselnde Agenten- und Inferenzlast | Cloud-Dienste oder skalierbare eigene Dienstarchitektur | Datenzugriff, Latenz, laufender Betrieb und Gesamtkosten |
| Entwicklung und Test für Apple-Plattformen | Mac-Entwicklungsumgebung, lokal oder in der Cloud | Kein Ersatz für NVIDIA-GPU-Rechnen oder Robotik-Edge-Hardware |
Ein Wechsel zu einer anderen Infrastruktur ist nicht automatisch ein Gewinn. Cloud-Dienste können bei dauerhafter hoher Auslastung laufende Kosten und Abhängigkeiten von Netzwerk und Anbieter mit sich bringen. Lokale Systeme verlangen Investition, Wartung und ausreichende Auslastung; sie sind unpraktisch, wenn Kapazität nur zeitweise benötigt wird. Ein Cloud-Mac wiederum adressiert Apple-Builds und Tests, aber keine GPU-Trainingslast. Für Teams, die nur vorübergehend eine Apple-Entwicklungsumgebung benötigen, kann die Miete eines Mac deshalb eine passendere Ergänzung als ein eigener Rechner sein; die verfügbaren Optionen lassen sich auf der Zutcloud-Seite zum Mac mini einordnen. Für ergänzende Hintergrundinformationen zu den angebotenen Entwicklungsumgebungen können Sie außerdem die Selbstdarstellung von Zutcloud heranziehen. Wer AI-Agent-Abläufe mit iOS- oder anderen Apple-Anwendungen verbindet, sollte den Entwicklungsrechner als Werkzeug für Build und Test betrachten, nicht als KI-GPU-Knoten. Entscheidend bleibt, dass Rechenlast, Latenzanforderung und Einsatzort getrennt geplant werden.
Von der Prognose zur Praxis
Lesen Sie in unseren technischen Leitfäden weiter, wie Sie Inferenz, Modellbetrieb und AI Agents im Alltag planen.
Nutzen Sie die Prüfliste, um bestätigte Ankündigungen von Prognosen zu unterscheiden und Ihre Notizen aktuell zu halten. Jetzt bestellen