GPU 训练需求还在,但预算和架构该往哪里挪,才能接住推理、Agent 和机器人工作负载?
先给判断:NVIDIA GTC Berlin 2026 前瞻的获胜方向,是从单纯扩大模型训练转向兼顾推理效率、AI Agent 持续运行和机器人训练部署的端云协同;只有当实际工作负载、时延与数据边界支持时,才应把任务迁往云端、边缘端或本地。这是依据工作负载变化作出的趋势判断,不是大会已确认的发布结论。
正在规划 AI 基础设施或算力预算的技术负责人,可用这份拆解梳理需求变化。
关注 AI Agent、Open Model 和机器人开发的工程师,可据此判断潜在的推理与部署负载。
行业观察者可用下文区分官方已确认的议程信息与预测。
最后更新于 2026 年 10 月 18 日;大会日期、地点及议程信息核实自 NVIDIA 官方常见问题和官方会议目录。
先用 NVIDIA GTC Berlin 2026 的已确认信息划清预测边界
截至更新日,官方确认大会将于 2026 年 10 月 21—22 日在柏林举行,主题演讲安排在 10 月 21 日,工作坊安排在 10 月 20 日。官方会议目录已上线,但议程项目不等于产品发布承诺;下文关于算力流向的判断,均是作者基于工作负载和部署条件的分析,不代表大会官方结论。日期与会期可在大会官方常见问题核对,具体议程应以官方会议目录为准。
GPU 需求接下来会怎么变?不应只盯着训练集群是否继续扩张,还要看推理服务如何满足延迟、吞吐和持续运行要求。大会值得观察的,不是某一款硬件的传闻,而是这些约束是否得到更明确的解决方案。
按 GPU 工作负载区分训练扩容与推理效率
训练和推理都消耗 GPU,但资源压力并不相同。训练通常需要反复计算、更新模型参数,并尽可能提高批量任务吞吐;在线推理则要在用户等待时间、并发、显存占用和服务可用性之间权衡。批量推理可以强调吞吐,交互式推理却不能无限等待批次形成。NVIDIA 的推理参考架构文档也将推理优化、服务、内存管理、云端编排和性能测试列为完整部署链条的一部分。
因此,推理占比提高不代表训练需求消失。新模型训练、微调和周期性更新仍需要计算资源;只是当模型进入常态化服务阶段,显存、缓存、请求调度、网络与稳定供给可能成为预算中的显性项目。对基础设施团队来说,按“GPU 数量”单独做规划容易漏掉服务端瓶颈:先记录并发与延迟目标,再评估批量策略和显存使用,最后决定增加计算资源还是优化部署。
把 AI Agent 拆成模型调用与外围服务
Agent 工作流新增的算力压力在哪里?核心变化可能不是单次回答变得更重,而是一个任务要经历多轮模型推理、上下文整理、工具调用和结果校验。NVIDIA 对Agent 推理工作负载的说明也强调,多步骤调用、长上下文和工具等待会改变会话长度与资源利用方式。
要区分 GPU 上的模型计算和外围负载。检索、数据库访问、权限校验、任务队列、日志与工作流编排,并不都需要 GPU;工具等待期间,GPU 甚至可能没有有效计算任务。因此,若 Agent 长时间运行,容量规划不能只用平均请求数来代表实际负载,还要观察单任务调用链、上下文增长、工具等待时间和并行子任务。
Agent 任务适合放在哪里?对数据敏感、必须离线或需要快速响应的感知和控制环节,更适合在本地或边缘设备处理;集中管理的模型服务、共享工具和弹性计算,可考虑放在云端。若任务会操作生产系统,还要把凭证隔离、人工确认和失败回滚纳入部署设计,而不是只比较推理速度。
核对 Open Model 的开放程度与部署成本
开放模型会如何影响推理部署?权重更容易获取,可能降低团队开展私有推理、微调和定制服务的门槛;但下载权重并不自动意味着训练数据、训练代码和许可条件都开放。开放权重、许可允许特定用途,以及符合完整开放定义,是不同层次,不能混为一谈。
开放源代码促进会的开放 AI 定义将模型参数、代码和数据相关信息纳入讨论。斯坦福《AI Index 2026》报告则记录,2025 年纳入统计的 95 个重要模型中,45 个通过 API 提供;报告还指出,超过 90% 的企业模型未公开训练代码。这些数据反映模型发布方式并不等同于完整开放,也提醒采购与工程团队逐项检查模型卡、许可和复现材料,而不是仅凭“开放”标签判断能否商用或私有部署。相关统计见报告原文。
私有部署也不等于成本自动下降:模型权重占用、量化带来的质量权衡、服务升级、访问控制和故障维护都要纳入评估。先验证许可是否覆盖目标用途,再用真实请求测试显存、响应时间和并发;如果负载很低或维护团队有限,托管推理可能仍更合适。
按机器人任务拆分云端训练与现场控制
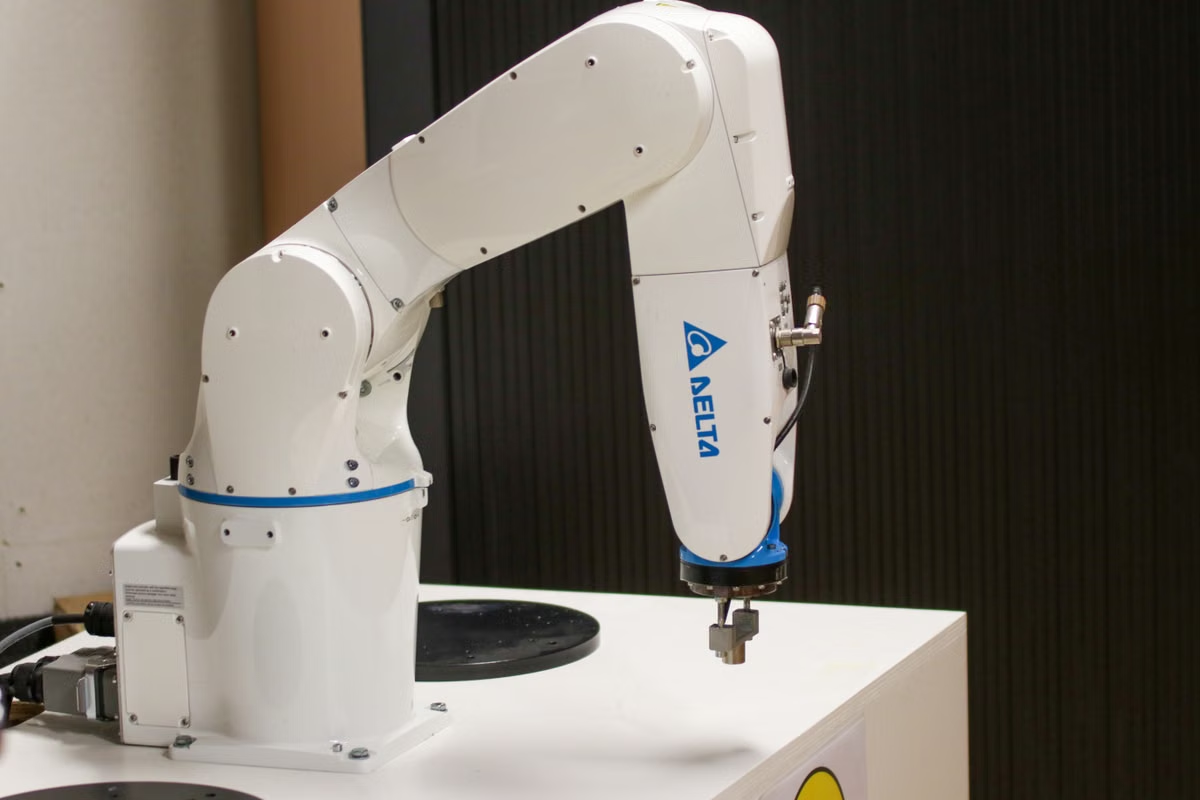
机器人算力至少有三类:训练和仿真、现场感知与控制、部署后的模型更新。训练和仿真可以使用集中式 GPU 资源处理大批实验;现场感知与控制则可能受到网络中断、响应时限和数据留在设备端等条件限制,不能简单交给远端云端推理。NVIDIA 的机器人平台资料把仿真、训练和部署描述为从云端延伸到边缘端的流程;其机器人开发资源也介绍了仿真训练与边缘部署的不同环节。
机器人项目需要怎样分配端云算力?更稳妥的判断是按安全与时延边界拆分:集中资源负责训练、仿真和批量评估;现场设备负责必须及时执行的感知与控制;网络可用且允许外传的数据,再按任务需要调用云端服务。模型更新则要经过版本验证与回滚设计,不能把远程更新能力当作无条件在线运行的保证。
⚠️ 机器人系统的云端推理可以补充现场能力,但无法替代所有现场计算。若安全动作依赖网络往返,必须先验证断网、延迟波动和回退策略,再决定把推理移出设备。
用工作负载清单判断算力该部署在哪里
下表用于比较部署方向,而不是预测哪种方案会在大会上发布。选型时,先按任务特点定位,再核对实际延迟、数据和运维要求。
| 选项 | 更适合的工作负载 | 决策前重点核对 |
|---|---|---|
| 云端 GPU | 集中训练、弹性推理、批量仿真 | 并发峰值、显存、数据传输、持续运行成本 |
| 边缘 GPU | 现场感知、低时延推理、网络受限任务 | 功耗、设备空间、断网运行和模型更新方式 |
| 本地设备 | 隐私敏感、离线或开发调试工作 | 可用内存、模型规模、工具链与维护能力 |
| 云端 Mac | Apple 生态应用构建、签名和开发流程 | 是否需要 macOS、Xcode 或 Apple 平台验证;它不等同于 NVIDIA GPU 训练节点 |
云端 Mac 的适用边界尤其要说清:它可用于 Apple 生态开发与构建,并不是 CUDA GPU 集群的替代品。若工作流涉及 iOS 构建,应先核对 Apple 开发工具链与运行环境的要求;服务使用规则可参考服务条款。若要评估租用方案,套餐信息可见配置与计价页面。这两类资源解决的是不同问题,不应合并到同一项 GPU 算力预算里。
用核对清单复核大会信息与算力计划
面对大会发布、媒体报道或社交平台讨论,可按这套顺序更新技术判断:
- ✅ 先核对来源层级:活动日期、议程和正式发布以官方页面或技术文档为准;媒体报道需标明报道来源,未获官方确认的内容仍按传闻处理。
- ✅ 再标记工作负载:注明讨论的是训练、微调、在线推理、Agent 编排、机器人仿真,还是现场控制,不用“AI 算力”笼统代替。
- ✅ 补上运行指标:记录推理频率、并发、上下文长度、目标时延、持续运行要求,以及工具调用和数据传输是否计入。
- ✅ 确定部署位置:把任务分别归入云端、边缘端或本地,并写明隐私、断网、安全和维护约束。
- ✅ 最后调整预算:先做代表性任务测试,再决定扩充 GPU、优化推理服务或把非 GPU 工作迁移到合适的 CPU、存储和开发环境。
结论仍是条件式的:如果 Agent 持续运行、在线推理和机器人部署的比重上升,算力规划就需要更多关注推理效率、服务连续性和端云分工;如果主要任务仍是训练或集中式批处理,训练资源仍是优先项。大会信息应在正式议程与发布资料出现后再修正,不能把预测写成已确认路线。
对比现有开发方式时,团队自有 Mac 可能受本机可用时间、协作访问和环境一致性限制;通用云主机则未必具备 Apple 平台所需的原生 macOS 工具链,但它们都不应被误当作 GPU 训练方案。若手头工作是阶段性 Apple 生态构建、测试或远程开发,租用 Zutcloud 的 Mac 环境可减少为单次工作流准备专用机器的负担;需要 GPU 训练或机器人仿真时,仍应选择匹配的 GPU 资源。可先按工作负载和时延要求判断部署位置,再查阅前述开发环境说明。
把大会前瞻变成可执行的算力清单
先继续阅读本站的 GPU 推理实践内容,按模型规模、并发量和延迟目标估算算力需求。
接着梳理 AI Agent 的运行方式,重点核对长任务、上下文管理与工具调用带来的资源消耗。 立即订购